Fotball og maskinlæring
Velkommen til det første tekniske innlegget her på bloggen! Det handler om forsterkningslæring, som jeg har brukt mye av fritiden min på i det siste.
Drømmen er å trene hele fotballag, 5 mot 5 eller 11 mot 11, og se om formasjoner, roller og spillestiler dukker opp av seg selv. Men først må det virke i det små, så denne første uka har handlet om 2 mot 2.
Oppsett
Miljøet er football-scenarioet i VMAS, en enkel 2D-simulator. Et mål gir 100 poeng, og laget får litt ekstra drahjelp når ballen beveger seg mot riktig mål. Hver kamp varer i 500 steg.
Jeg trener med BenchMARL, som bygger på TorchRL, på én GPU, med 4096 kamper som går parallelt. Motstanderen er en ferdigskrevet bot som jeg skrur gradvis opp fra stillestående til full styrke, 50M frames per trinn. Uten den trappen kom laget aldri i gang.
Det viktigste jeg lærte om hastighet: det er antall oppdateringer som begrenser, ikke mengden data. Store batcher med høyere læringsrate ga mest igjen per time.
PPO, IPPO og MAPPO
Jeg har prøvd alle tre. De bygger på samme PPO-oppskrift, men skiller seg i hvem som lærer og hva kritikeren får se:
- PPO: én agent som lærer alene. Det brukte jeg i 1 mot 1.
- IPPO: hver spiller lærer som om medspilleren bare er en del av miljøet. Begge deler samme nettverk og vet hvilken spiller de er.
- MAPPO: som IPPO, men kritikeren ser hele laget under trening.
IPPO og MAPPO gikk gjennom samme trapp side om side, med én kjøring hver. Tallene er snittpoeng per kamp mot slutten av hvert trinn:
| Botens styrke | IPPO | MAPPO |
|---|---|---|
| 0 | 112 | 103 |
| 0,25 | 114 | 112 |
| 0,5 | 109 | 106 |
| 0,75 | 56 | 38 |
| 1,0 | −4 | −27 |
IPPO var like god eller bedre hele veien. Det gir mening: hver spiller ser allerede hele banen, så MAPPOs kritiker får ikke vite noe nytt.
0–0 som strategi
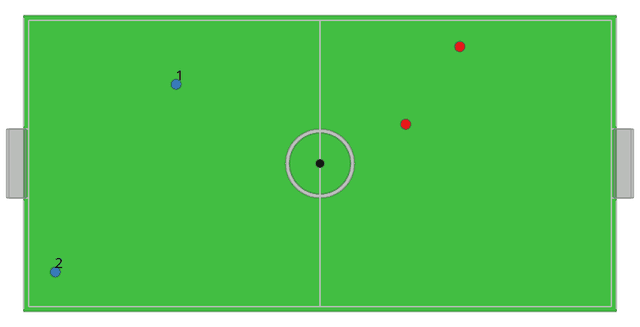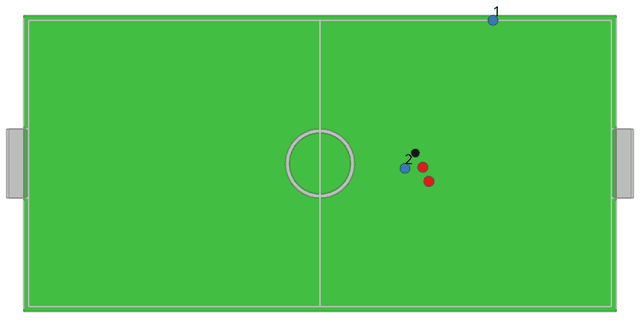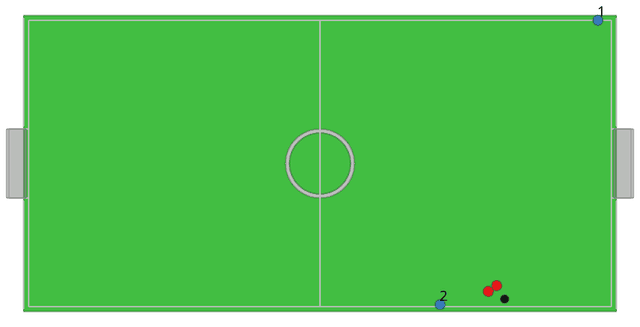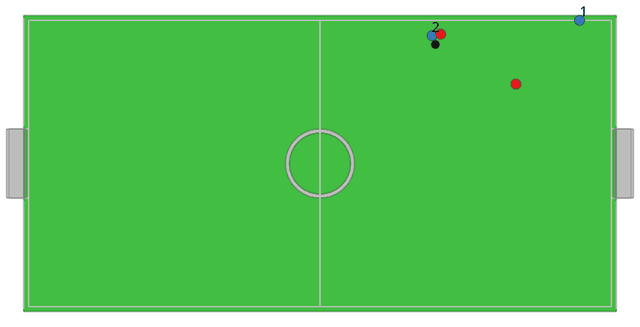
Botten spilte så mot seg selv en del. Det endte nesten alltid 0–0:
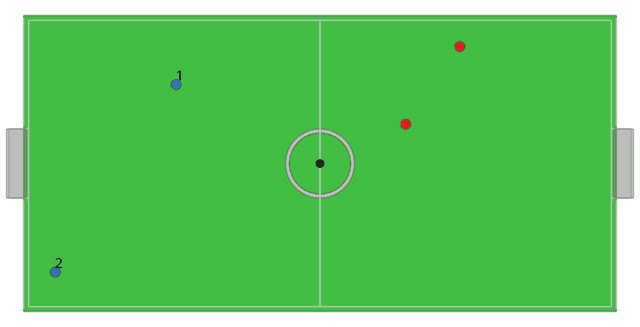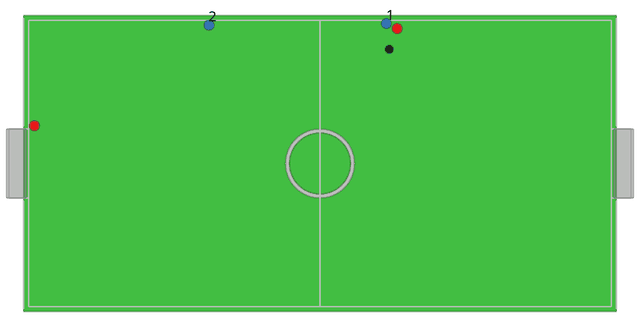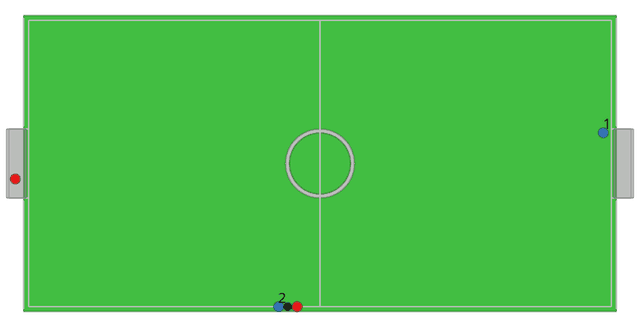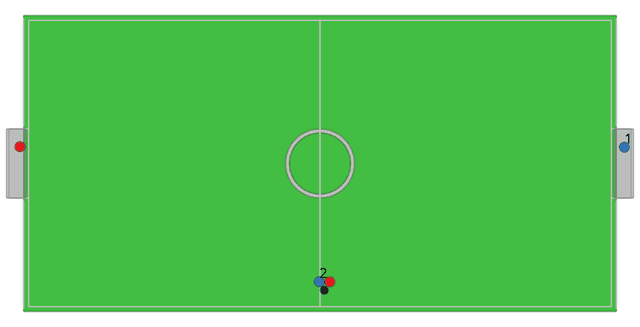
Dette var veldig gøy å se! Samtidig veldig frustrerende. Det satte i gang en god del graving. Dermed bygde jeg en haug logging og tooling for å sjekke sunn læring og slike handlingsmønstre under trening.
Neste kamp
Nå kjører en liga, inspirert av AlphaStar. Hovedlaget får selskap av en motstander som bare har én jobb: å finne svakhetene dets. Håpet er at det tvinger lagene ut av 0–0-strategien.
Virker det, blir det mer undersøkning om hvorfor og hvordan. Samt kanskje ett blogginnnlegg til. Takk for kampen.
Tidligere arbeid
Lite av dette er nytt. Her er arbeidet jeg har lent meg på:
Algoritmer
- Schulman mfl. (2017): Proximal Policy Optimization Algorithms. PPO.
- de Witt mfl. (2020): Is Independent Learning All You Need in the StarCraft Multi-Agent Challenge?. IPPO.
- Yu mfl. (2022): The Surprising Effectiveness of PPO in Cooperative, Multi-Agent Games. MAPPO, og at den ikke skiller seg fra IPPO når alle ser hele banen.
Verktøy
- Bettini mfl. (2022): VMAS: A Vectorized Multi-Agent Simulator for Collective Robot Learning
- Bettini mfl. (2023): BenchMARL: Benchmarking Multi-Agent Reinforcement Learning
- Bou mfl. (2023): TorchRL: A data-driven decision-making library for PyTorch
Fotball
- Kurach mfl. (2019): Google Research Football: A Novel Reinforcement Learning Environment
- Liu mfl. (2019): Emergent Coordination Through Competition. DeepMinds 2 mot 2, det nærmeste forbildet.
- Liu mfl. (2021): From Motor Control to Team Play in Simulated Humanoid Football
- Lin mfl. (2023): TiZero: Mastering Multi-Agent Football with Curriculum Learning and Self-Play. 11 mot 11 med en trapp av motstandere, som min.
Selvspill og ligaer
- Bansal mfl. (2017): Emergent Complexity via Multi-Agent Competition
- Berner mfl. (2019): Dota 2 with Large Scale Deep Reinforcement Learning. OpenAI Five.
- Vinyals mfl. (2019): Grandmaster level in StarCraft II using multi-agent reinforcement learning. AlphaStar og ligaen.